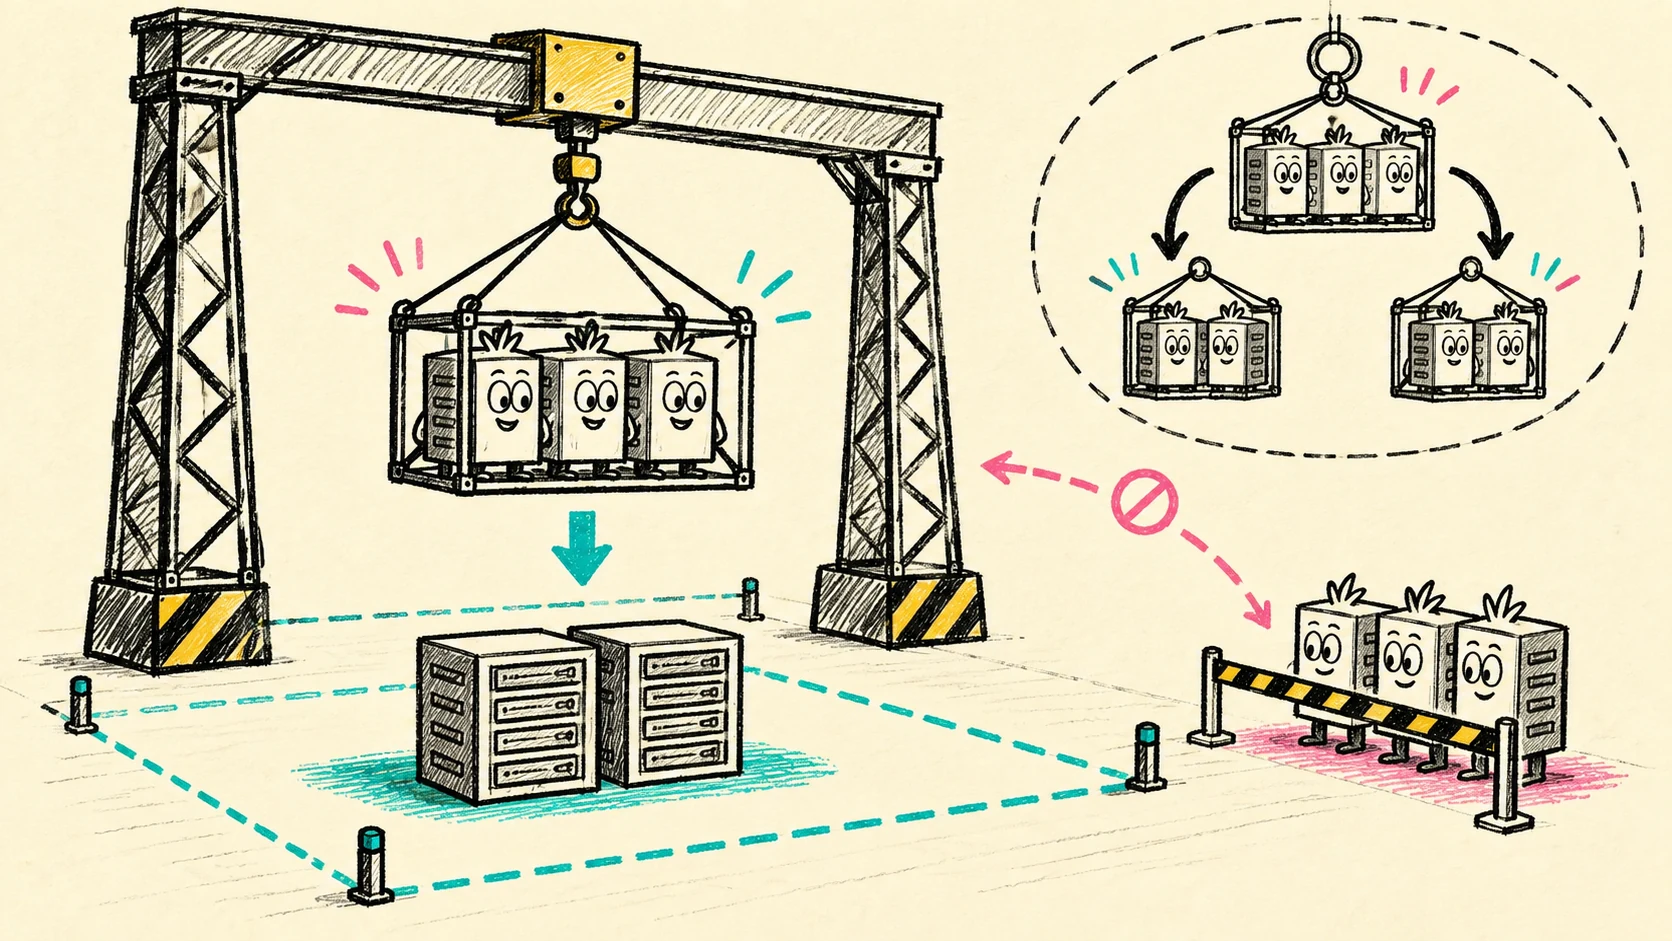
Как Kubernetes 1.37 размещает распределённую задачу целиком
Что меняют PodGroup, gang scheduling и CompositePodGroup для распределённых задач: минимальный состав, топология, вытеснение и границы beta/alpha.
Как scheduler освобождает ресурсы для работающего Pod, почему PDB не даёт абсолютной защиты и что измерить перед включением экспериментального resize-preemption.
Раздел: MLOps
6 публикаций
Разделы архива
Что меняют PodGroup, gang scheduling и CompositePodGroup для распределённых задач: минимальный состав, топология, вытеснение и границы beta/alpha.
Практическая схема predictive autoscaling для GPU: измерить lead time, прогревать ёмкость волнами, проверить прогноз в shadow mode и оставить реактивный safety net.
Как превратить общий GPU-пул в production-платформу: validation gate, topology-aware allocation, trust domains, remediation и измеримый self-service.
Почему OpenCost 1.121.0 разделяет usage- и allocation-стоимость LLM-инференса, как связывает vLLM-метрики с расходами Kubernetes и где labels превращают цену в ноль.
Как единый Kubeflow SDK проводит ML-код от локального процесса до Kubernetes — и какие версии, квоты, доступы и наблюдаемость всё равно остаются обязанностью платформы.
Почему здоровые Pod и правильная network policy могут остановить распределённую тренировку — и как topology-aware placement возвращает GPU к работе.


