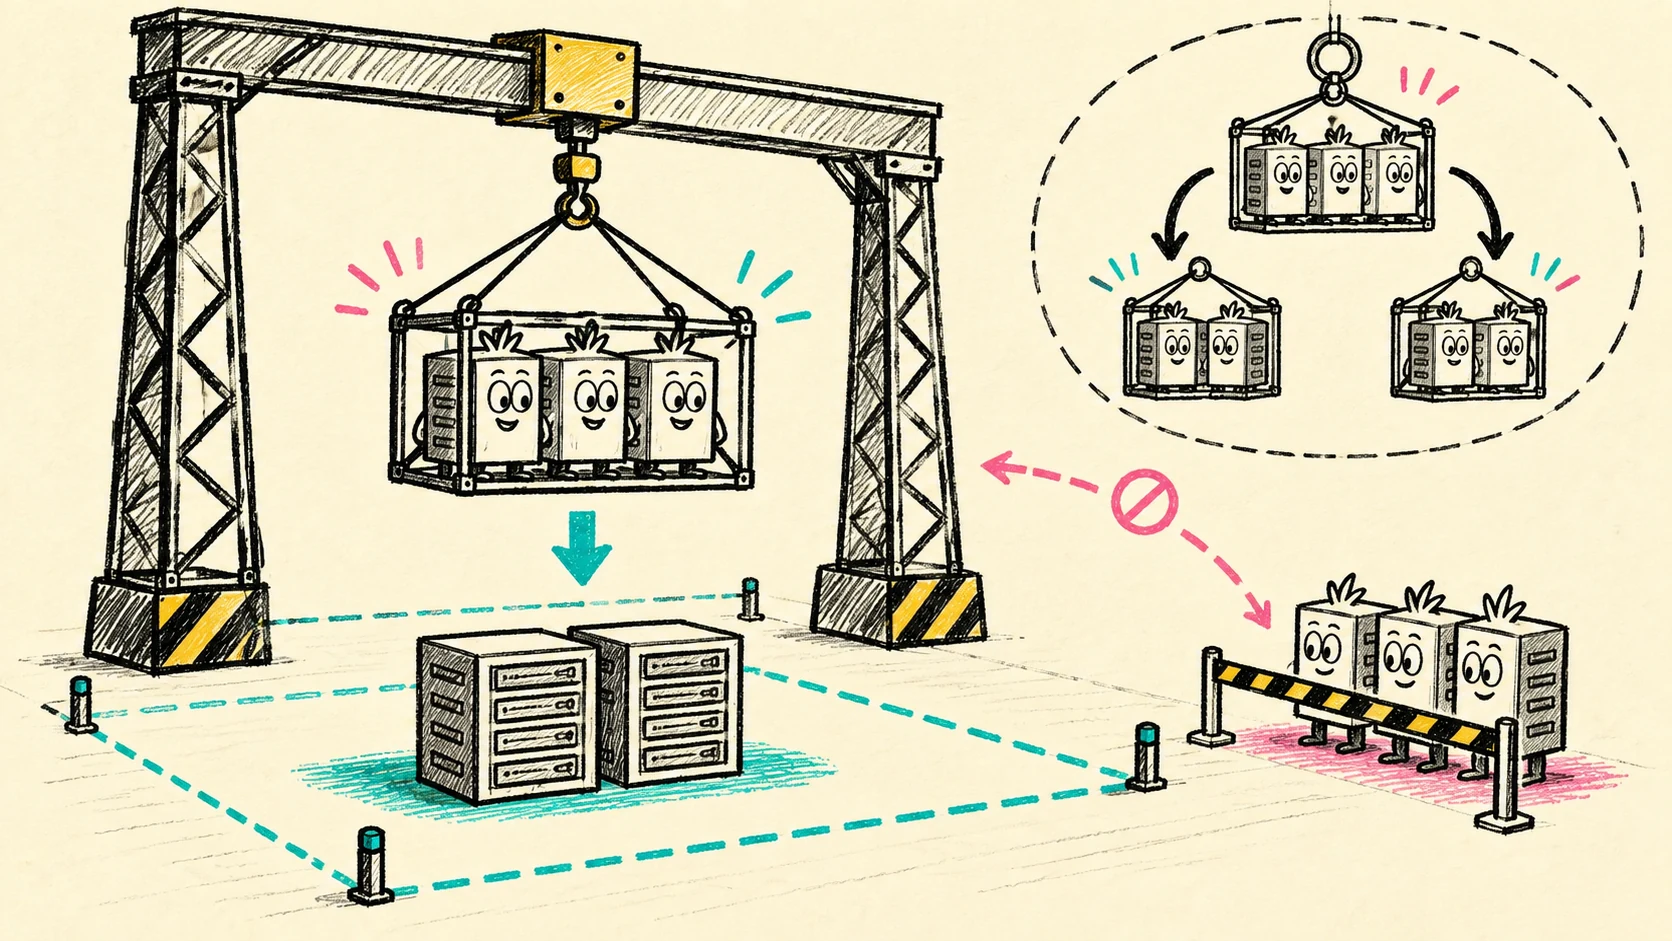
Четыре worker-процесса заняли GPU, пятый остался Pending, вычисление ждёт всех участников. Это типовой сценарий распределённой нагрузки: успешное размещение отдельных Pod ещё не даёт работающей задачи. Workload-Aware Scheduling позволяет описать минимальный состав группы и искать ресурсы для неё совместно. В Kubernetes 1.37 базовые API перешли в beta, но расширения для иерархий и топологии пока требуют отдельного экспериментального внедрения.
Разбор адаптирован из официальной публикации Kubernetes от 8 сентября 2026 года. Авторы: Antoni Zawodny, Bartosz Rejman, Maciej Skoczeń, Maciej Wyrzuc и Matt Matejczyk из Google; Heba Elayoty и Jon Huhn из Microsoft. Исходный материал распространяется по CC BY 4.0. Здесь изменены структура и формулировки, добавлены рекомендации для пилота. Документация проверена 9 сентября; собственного нагрузочного теста этих возможностей мы не проводили.
Сначала определите минимальный рабочий состав
Gang scheduling полезен, когда частично размещённая группа не способна выполнять полезную работу. Планировщик должен найти допустимое размещение для минимального числа участников прежде, чем назначать их на узлы. Если же каждый worker независимо обрабатывает сообщения, ожидание всей группы может только задержать старт. Я бы начинал внедрение с задач, у которых зависимость от полного состава подтверждается поведением приложения.
В модели Kubernetes эти требования разделены между объектами. Workload хранит шаблоны политик планирования. PodGroup описывает конкретную группу во время выполнения; Pod ссылается на неё через spec.schedulingGroup.podGroupName. Связь с контроллером остаётся существенной: создание шаблона само по себе не порождает все нужные Pod. Жизненным циклом приложения продолжает управлять Job или другой workload-контроллер.
У политики gang параметр minCount задаёт минимальное число Pod, для которых требуется найти размещение. Он выражает требование планировщику, а не готовность приложения к обмену данными. После назначения на узлы контейнеры ещё должны запуститься, загрузить модель, установить соединения. Проверки readiness и тайм-ауты распределённого протокола остаются частью приложения.
В версии 1.37 minCount разрешено менять. Это полезно для эластичной задачи, умеющей работать разным составом. Но уменьшение значения в API не научит неэластичное приложение обходиться без участника. Порог следует брать из требований вычисления; иначе планировщик выполнит новый контракт, а программа продолжит ждать прежний состав.
Группа появилась и в очереди планировщика
Изменилось внутреннее представление ожидающей работы. Раньше Pod одной группы стояли в очереди по отдельности. Теперь верхнеуровневый PodGroup становится самостоятельным элементом очереди, поэтому участники разделяют поведение ожидания. Для инженера, разбирающего задержку запуска, это ещё одна причина смотреть на группу целиком.
В документации PodGroup приведены kubectl get podgroups и kubectl describe podgroup training-worker-0. Последняя команда использует имя из примера документации; в своём namespace подставьте имя реальной группы. Диагностику группы сопоставляйте с ограничениями её Pod: свободное суммарное количество CPU ничего не доказывает, если нужные узлы не подходят по памяти, устройствам или правилам размещения.
Один из тупиков при таком разборе — бесконечно уменьшать requests, пытаясь получить хоть какой-нибудь старт. Если ресурсы заданы по измерениям, проблема может быть в невыполнимой комбинации требований. Для пилота полезнее отдельно проверить ресурсную ёмкость и ограничения размещения, чем менять оба условия одновременно и потом гадать, что помогло.
Иерархия описывает разные части одной задачи
Плоской группы недостаточно, если у вычисления есть driver и несколько наборов workers с разными требованиями. Новый CompositePodGroup объединяет дочерние PodGroup или другие CompositePodGroup в дерево. Родитель задаёт общие условия, листья сохраняют требования отдельных частей приложения.
В официальном примере родитель требует две дочерние группы: workers с minCount: 4 и driver с minCount: 1. На родительском уровне используется minGroupCount, который считает группы, а не Pod. Подмена этих величин меняет смысл допуска задачи. Планировщик проверяет требования по дереву; если условия корня не выполняются, иерархия остаётся неразмещённой.
Топологические ограничения тоже можно расположить по уровням: вся задача должна попасть в одну зону, workers — в одну стойку внутри этой зоны, driver — в подходящую стойку там же. Это позволяет выразить близость участников точнее, чем одним общим правилом. Однако более узкая топология уменьшает множество допустимых размещений. Наличие свободных GPU в соседней зоне не поможет, если контракт требует другую комбинацию.
Здесь я бы остановился перед добавлением очередного уровня. Если приложение нормально работает без требования общей стойки, не стоит закреплять его ради предполагаемого ускорения. Сначала измерьте чувствительность вычисления к сети, затем сравните выигрыш с временем ожидания подходящей ёмкости. Опубликованный API не обещает, что ограниченная топология улучшит именно вашу задачу.
Вытеснение теперь учитывает судьбу группы
С предыдущей версией связано эксплуатационно важное отличие. В 1.36 обычное вытеснение для одиночных Pod не учитывало disruptionMode PodGroup и могло затронуть одного участника группы, которой требовалось совместное поведение. В 1.37 этот путь учитывает настройку группы.
Заодно переименованы значения: прежний режим PodGroup стал all, а Pod стал single. Речь здесь о семантике вытеснения планировщиком. Режим all не превращается в защиту от отказа узла, падения процесса или потери сети. Для распределённого приложения по-прежнему нужны восстановление и контрольные точки там, где их поддерживает вычислительный движок.
Отдельный feature gate WorkloadAwarePreemption объединён с GenericWorkload. Поэтому конфигурацию раннего пилота нельзя переносить между версиями как непрозрачный набор флагов. Сверьте API version, названия полей и фактические компоненты control plane, которые будут исполнять политику.
Beta здесь выключена по умолчанию
Workload API и PodGroup используют scheduling.k8s.io/v1beta1. Их feature gate GenericWorkload в 1.37 имеет статус beta, но выключен по умолчанию. Для использования его включают на kube-apiserver, kube-controller-manager и kube-scheduler. Одного обновления версии кластера недостаточно.
У CompositePodGroup другой уровень зрелости: alpha, API scheduling.k8s.io/v1alpha3 и отдельный gate. Topology-Aware Workload Scheduling также остаётся alpha; обе возможности выключены по умолчанию. Для включения CompositePodGroup на controller-manager публикация дополнительно требует TopologyAwareWorkloadScheduling. Не объединяйте эти возможности в одну отметку «WAS включён» в эксплуатационной документации: у них разные зависимости и риски обновления.
Интеграция с нативным Job тоже включается отдельно, через WorkloadWithJob, и по умолчанию выключена. При её использовании поле .spec.scheduling позволяет выбрать политику; если gang.minCount опущен, он берётся из parallelism. Без выбора gang сохраняется обычное планирование по Pod. Документация на дату проверки отмечает эту интеграцию как alpha, даже при beta-статусе базового Workload API.
Что проверить на одной тестовой задаче
Начните с плоской группы и известного минимального состава. На отдельном стенде создайте дефицит ёмкости для одного участника и проверьте, что группа ожидает по заявленной политике. Затем верните ёмкость и дождитесь не только назначения Pod, но и первого полезного результата вычисления.
Следующий тест — вытеснение низкоприоритетной группы при появлении более приоритетной нагрузки. Заранее определите допустимое поведение single или all, проверьте фактический результат и восстановление приложения. Для эластичной задачи отдельно испытайте изменение minCount; для жёстко фиксированного состава этот тест не нужен.
Добавляйте иерархию и топологию только после того, как базовая группа понятна в диагностике. Если пилот не может объяснить, почему задача ждёт и кто должен освободить ей ресурсы, переносить эту схему на общий GPU-кластер рано. Рабочий критерий внедрения — воспроизводимое размещение и восстановление целой задачи при реалистичном дефиците ресурсов.