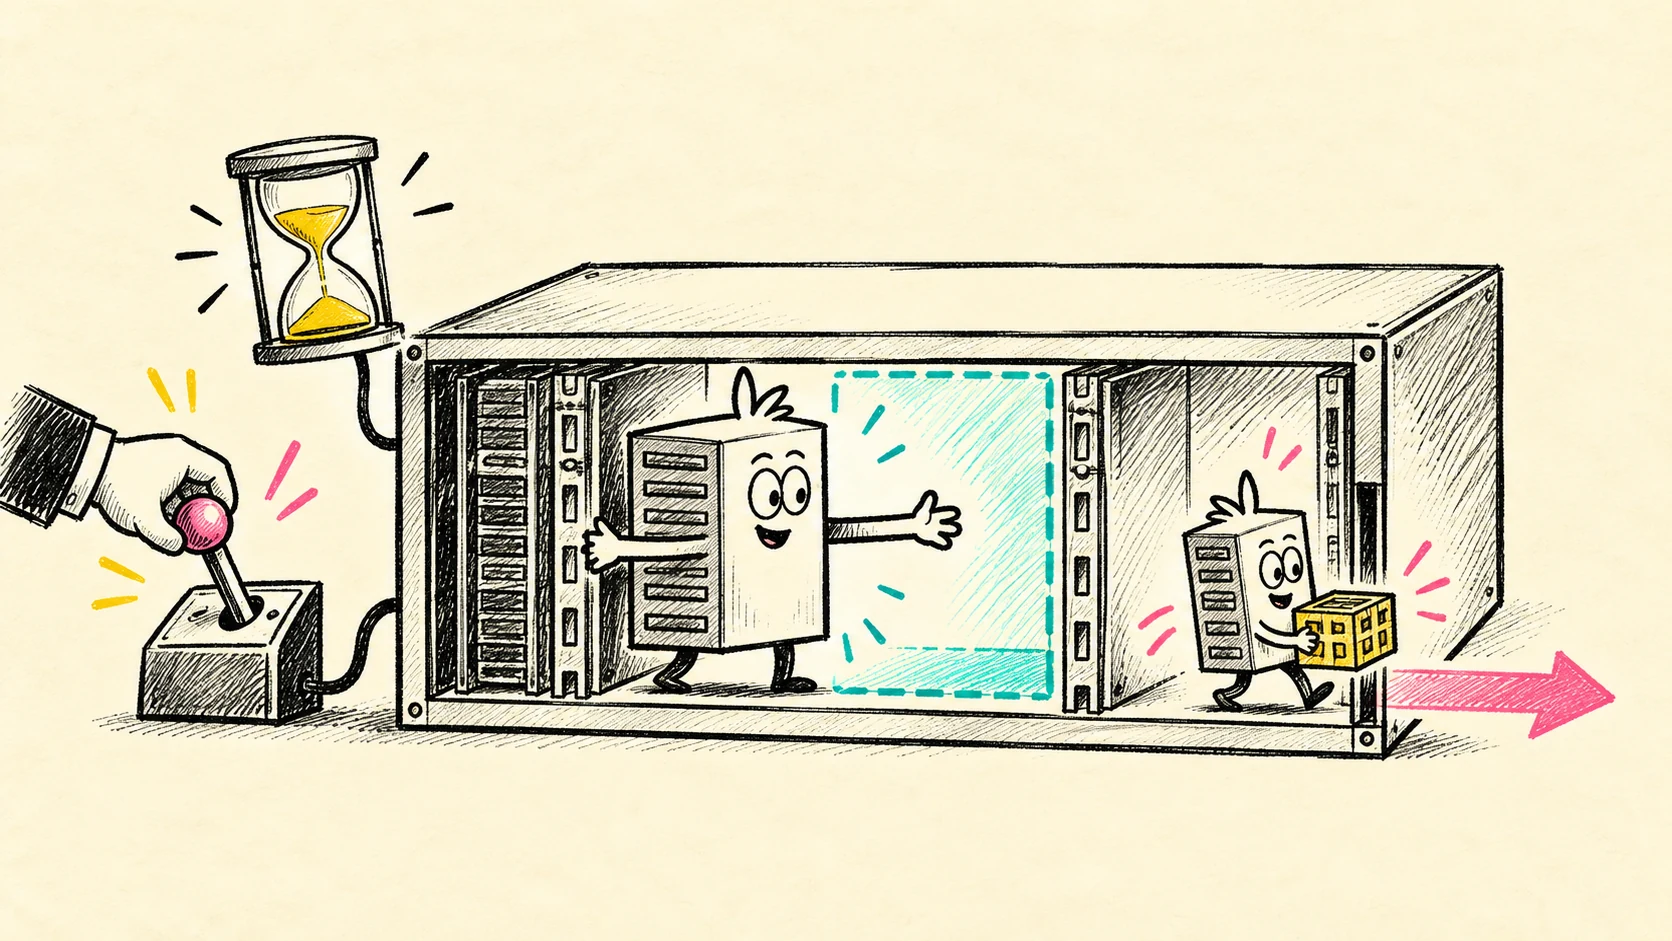
Работающему приложению понадобилось больше CPU, но свободное место на узле уже заняли фоновые задачи. Запрос ресурсов обновлён, а фактическое выделение не меняется. Kubernetes 1.37 добавляет экспериментальный выход: scheduler может вытеснить менее приоритетных соседей ради увеличения ресурсов этого Pod. Для критичного сервиса это полезно; для платформенной команды это ещё одна причина заранее договориться, чью работу разрешено прерывать.
Материал адаптирует статью Natasha Sarkar из Google от 10 сентября 2026 года, опубликованную в блоге Kubernetes под CC BY 4.0. Структура переработана, добавлены рекомендации для пилота и уточнения по официальной документации. Проверка источников проведена 11 сентября; собственный нагрузочный эксперимент не выполнялся.
Почему изменение requests может зависнуть
In-place resize сохраняет размещение Pod. Из этого следует неприятное ограничение: свободная память на другом узле не помогает приложению, которое должно вырасти здесь. Если текущего запаса не хватает, kubelet откладывает применение изменения. Перенос приложения на более крупную машину потребовал бы отдельного решения и уже другого сценария восстановления.
Новая функция подключает scheduler к таким отложенным запросам. Он рассматривает менее приоритетные Pod только на том узле, где работает увеличиваемый Pod, и может освободить их ресурсы. Удаление соседа и применение новых ресурсов разделены во времени. Если подходящих ресурсов всё равно недостаточно, ожидание продолжится.
Считать эту возможность штатной настройкой после обновления нельзя. В коде Kubernetes v1.37.0 gate InPlacePodVerticalScalingSchedulerPreemption имеет статус Alpha и значение Default: false. Я бы начинал с отдельного тестового кластера. Если сервис уже переживает рост нагрузки за счёт реплик и измеренного запаса ресурсов, экспериментальная preemption не становится обязательной только потому, что появилась в релизе.
Сначала проверьте, чего именно ждёт kubelet
Для диагностики берите структуру статуса из актуальной инструкции по resize. Ожидание отражается условием PodResizePending; причина Deferred означает временную невозможность, а Infeasible — невозможность выполнить запрос на текущем узле. PodResizeInProgress показывает, что ресурсы уже выделены, но изменение ещё применяется.
Это уточнение существенно для автоматизации: в исходном анонсе встречается описание через containerStatuses[].resizeStatus, тогда как инструкция использует Pod conditions. Не переносите путь из пересказа в alert или контроллер без проверки реального объекта API.
Сопоставляйте желаемую спецификацию, условия и observedGeneration. Иначе старый результат resize легко принять за ответ на последнее изменение. Отдельно проверьте resizePolicy: она определяет, требуется ли перезапуск контейнера при изменении конкретного ресурса. Слова «in-place» сами по себе не обещают отсутствия перезапуска при любой политике.
В runbook полезно записать два разных вопроса: «изменение принято?» и «приложение получило ресурс?». Успешный запрос к API отвечает только на первый. Для второго нужны наблюдения за применением и за поведением самого приложения. Если после увеличения CPU задержка не снизилась, сначала проверьте, действительно ли CPU ограничивал обработку; повторный рост requests может лишь вытеснить ещё одну полезную нагрузку.
Кто платит за свободное место
Приоритет стоит обсуждать как право прерывать чужую работу. Название critical в манифесте не доказывает, что команда оценила последствия. Перед пилотом составьте список потенциальных соседей и спросите их владельцев, что произойдёт после завершения процесса посередине задания. Потеряется ли прогресс, будет ли повторная обработка, допустим ли повтор внешнего действия?
Особенно внимательно отнеситесь к batch-задачам с побочными эффектами. Вычисление отчёта, которое можно повторить, и выгрузка, повторно списывающая деньги, требуют разных условий запуска. Scheduler не знает прикладной цены прерывания. Её приходится выражать архитектурой обработки, сохранением прогресса и правилами размещения.
PDB тоже не стоит превращать в обещание неприкосновенности. Документация preemption прямо описывает соблюдение PodDisruptionBudget как best effort: scheduler старается выбрать жертв без нарушения бюджета, но бюджет не даёт абсолютной защиты. Там же важен период graceful termination: между решением о вытеснении и доступностью ресурса есть задержка.
Поэтому я бы не использовал этот механизм как единственную защиту от немедленного OOM. Измерьте, сколько времени приложение выдерживает нехватку ресурса, и сравните с полным временем освобождения места. Если запас заканчивается раньше, оставляйте headroom или меняйте стратегию масштабирования. Уменьшать время завершения соседей ради красивого результата теста допустимо только после проверки их корректного shutdown.
Пилот должен показывать и неуспех
Сделайте тест воспроизводимым: зафиксируйте версии компонентов, включённые gates, доступные ресурсы узла, requests тестовых Pod и их PriorityClass. Включение Alpha должно быть согласовано для нужных компонентов, а не проверено только по одному конфигурационному файлу. Учитывайте системные Pod: рекламное число CPU машины не равно свободному бюджету эксперимента.
Начните с небольшой CPU-нагрузки и соседа, которого безопасно завершить. Сначала подтвердите, что без нехватки ресурсов resize проходит. Затем создайте дефицит и проследите всю цепочку: запрос увеличения, ожидание, выбор соседа, его завершение, применение новых ресурсов. Сохраните события с временем, UID Pod и поколением спецификации. Это даст основание сравнивать повторные прогоны, не смешивая разные объекты с одинаковым именем.
После успешного прогона повторите сценарий без подходящего низкоприоритетного соседа. Ожидаемое ограничение здесь полезнее демонстрации успеха: команда увидит, как выглядит продолжительное ожидание и какой сигнал получит дежурный. Ещё один тест — медленное завершение жертвы. Наблюдайте не только растущий Pod, но и очередь прерванной нагрузки, повторные попытки и время её восстановления.
Наконец, проверьте конкурирующие запросы увеличения. Практический вопрос — понимает ли оператор, почему одно приложение получило ресурс раньше другого, и способен ли остановить контроллер, который продолжает повышать requests. Зафиксируйте владельца этого контроллера и отдельную процедуру остановки эксперимента. Выключение gate не возвращает уже завершённый процесс и не отменяет его внешние действия.
Для каждой попытки сохраните и результат на стороне клиента: таймауты запросов, длительность обработки задания, размер накопившейся очереди. Не назначайте универсальный допустимый порог из чужого примера. Его задаёт договорённость с владельцем сервиса. Если тест считается успешным только по исчезновению условия ожидания, он пропускает ситуацию, когда ресурсы выделены правильно, но пользовательская операция уже завершилась ошибкой. Именно такой результат должен остановить расширение пилота.
Когда оставить резерв
Критерий полезности пилота я бы сформулировал через два результата: критичный сервис успевает получить ресурс, а прерванная работа восстанавливается в согласованных пределах. Процент заполнения узла сам по себе этого не показывает.
Если восстановление соседей ещё не проверено, оставьте резерв ресурсов. Когда цена прерывания известна, есть наблюдаемость ожидания и отработан останов пилота, resize-preemption можно оценивать как конкретный способ распределения ограниченной ёмкости. Решение должно опираться на измеренное поведение обеих нагрузок, а не только на отсутствие рестарта у выигравшего Pod.