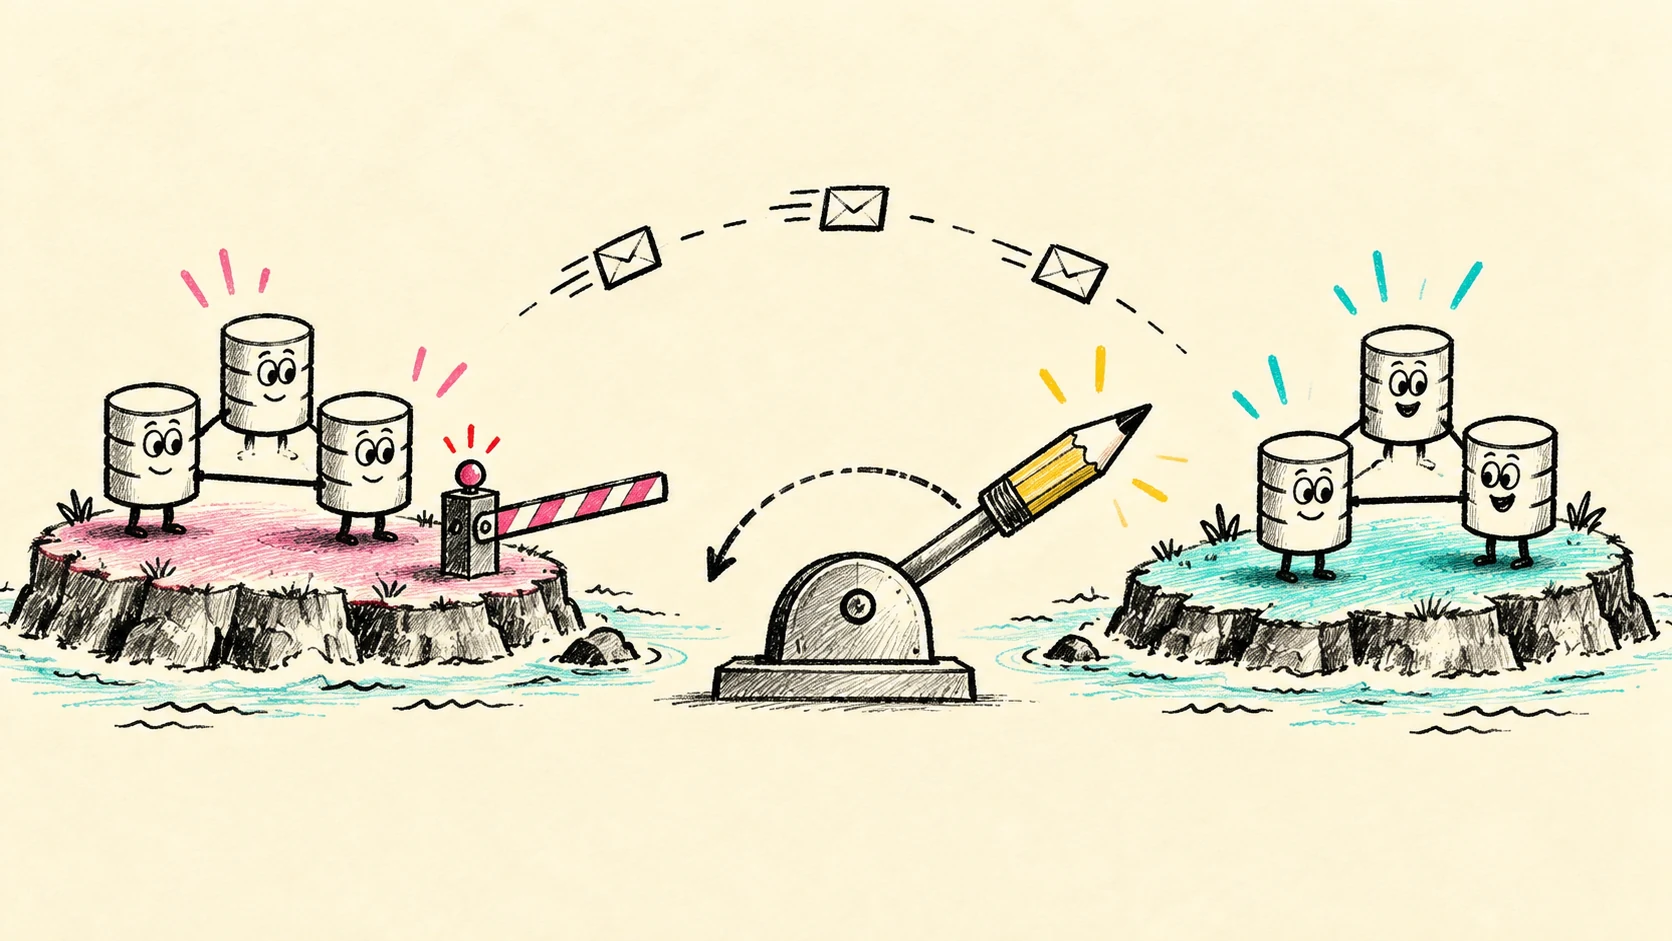
Локальный MySQL-кластер может пережить отказ узла и всё равно потерять доступность вместе с площадкой. Для такого случая нужна отдельная реплика, но её наличие не гарантирует ни нулевой потери данных, ни безопасного переключения записи. В MySQL InnoDB ClusterSet эти задачи разделены: Group Replication работает внутри площадок, асинхронный канал связывает их между собой, а перенос основной роли остаётся явным действием оператора.
Инженер Percona Mayank Shah разбирает эту схему на Percona Operator for MySQL. Ниже — адаптация его практики с проверкой по актуальной документации. Главный вопрос здесь не «как создать второй кластер», а «какие условия должны выполняться, прежде чем разрешить ему запись».
Разделите локальную доступность и межплощадочное восстановление
В ClusterSet один кластер принимает запись, остальные работают как реплики только для чтения. Каждая площадка содержит собственную группу MySQL. Между площадками изменения передаются асинхронно: удалённая реплика может отставать, даже когда все её узлы исправны.
Поэтому зелёный статус локальной группы не отвечает на вопрос о готовности к потере основного региона. Проверять приходится два состояния: здоровье самой реплики и продвижение межкластерной репликации. Если основная площадка исчезнет до передачи последних транзакций, на выбранной реплике этих транзакций не будет.
RPO задаёт допустимую потерю данных, RTO — допустимое время восстановления сервиса. Лаг помогает оценивать риск потери, но последнее измерение до обрыва связи не доказывает актуальность реплики в момент аварии. Зафиксируйте, какие данные доступны для решения и где начинается неизвестность. Обещать нулевой RPO только по наличию ClusterSet нельзя.
Подготовьте реплику к присоединению, а не к самостоятельной жизни
В примере Percona обе площадки используют group-replication. Для будущей реплики автор отдельно задаёт spec.mysql.bootstrap.mode: manual. Без этого обычный запуск стремится сформировать самостоятельную группу, тогда как здесь требуется принять данные основной площадки и присоединиться к общей топологии.
Ожидание первого Pod на этой стадии не обязательно означает поломку. До принятия в ClusterSet он может оставаться неготовым. Разбирайте состояние вместе с этапом развёртывания, а не исправляйте любой NotReady принудительным bootstrap. Иначе попытка «поднять кластер» нарушит исходный план создания реплики.
Перед развёртыванием сверьте совместимость оператора, сервера и MySQL Shell. В исходной статье поддержка ClusterSet начинается с оператора 1.2.0. Это не разрешение подставлять произвольный образ помощника из ветки разработки: используйте совместимые версии из документации своего релиза. Пример манифеста объясняет поля, но не заменяет готовую конфигурацию окружения.
Проверьте сеть и секреты до копирования данных
Участники ClusterSet связаны сетевыми адресами, а не ссылками Kubernetes на объекты соседнего кластера. Имя сервиса из локального DNS само по себе не станет доступно в другом регионе. Проверьте маршрутизацию и разрешение имён из тех компонентов, которые управляют топологией и передают данные.
Статья выделяет пароль пользователя clusterset. Актуальные требования Percona шире: системные учётные данные должны совпадать между участниками. Не сводите подготовку к переносу одного поля, не проверив требования выбранной версии. Секреты передавайте штатным защищённым механизмом, без вывода в журналы CI.
Для межрегиональной репликации настройте TLS явно. Режим автоматического выбора не равен обязательной проверке личности сервера. Уровень проверки сертификатов должен соответствовать принятой модели доверия и фактическим именам endpoints. Это отдельная проверка перед присоединением, а не косметическая настройка после запуска.
Выберите способ начального наполнения
Полный clone удобен, когда данные и сеть позволяют передать весь набор за приемлемое время. Но на большой базе он нагружает донора, занимает канал и дорого обходится при повторе после обрыва. В расчёте должны быть не только объём данных, но и допустимое влияние на основной сервис.
Альтернативный сценарий из статьи — предварительное восстановление копии и последующее догоняющее применение изменений через incremental. Для него нужны необходимые binary logs на источнике. Если они исчезнут раньше завершения подготовки, наличие восстановленных файлов не обеспечит успешное догоняние.
Не считайте любую резервную копию подходящей для такого сценария. Документация отдельно ограничивает восстановление копий с метаданными ClusterSet в новый кластер. До выбора этого пути проверьте точную процедуру для вашей версии и происхождения backup. Репетиция восстановления должна предшествовать обещанию готового резерва.
Плановое переключение требует подтверждённого результата
Когда обе площадки доступны, используйте switchover. В описанной схеме изменение spec.primaryCluster запускает согласованный перенос роли: реплика догоняет основную площадку, затем прежняя основная становится доступной только для чтения.
Применение манифеста ещё не означает завершение операции. Сверьте статус ClusterSet, результат выполняемой работы и фактическую основную роль. После этого проверьте маршрут приложения: запись должна попадать на новую площадку. Прямое подключение к старому адресу не превращается в корректный клиентский маршрут от одного изменения роли базы.
Завершайте проверку чтением записанных данных через ожидаемый путь приложения. Отдельно убедитесь, что прежняя площадка больше не принимает клиентскую запись. Такая проверка подтверждает результат переноса, а не только успешное исполнение управляющей команды.
Аварийное продвижение не исправляет разделение сети
Для недоступной основной площадки существует unsafeFlags.forcedFailover. Это явное принятие риска: асинхронная реплика может не иметь последних транзакций. Не используйте флаг как способ протолкнуть плановое переключение, которое завершилось ошибкой.
Недоступность из точки зрения контроллера не доказывает, что старый primary выключен. При разделении сети он может оставаться доступным части клиентов. До продвижения резервной площадки исключите запись на старую — например, предусмотренным в вашем окружении механизмом изоляции. Иначе появятся две расходящиеся истории данных. На это прямо указывает процедура forced failover Percona.
Вернувшийся кластер нельзя автоматически объявлять исправной репликой. После аварийного переключения требуется проверка состояния и согласованности транзакций, затем контролируемое возвращение в топологию. MySQL описывает этот процесс отдельно: проверка и rejoin не выполняются автоматически.
Практический итог — два разных сценария в runbook. Для планового переноса докажите синхронизацию и смену ролей. Для аварийного сначала исключите конкурирующую запись и зафиксируйте риск потери данных. Kubernetes автоматизирует исполнение, но не принимает за команду решение, какой риск допустим.
Источник и лицензия
Автор: Mayank Shah, Senior Software Engineer в Percona. Корпоративный блог: Percona Community. Исходная статья: Cross-site Disaster Recovery with Percona Operator for MySQL, 6 июля 2026 года.
Лицензия — CC BY 4.0, согласно условиям Percona Community. Это русскоязычная адаптация: структура переработана, команды сокращены, ограничения уточнены по документации на 11 сентября 2026 года. Автор и Percona не заявляли об одобрении этой публикации.