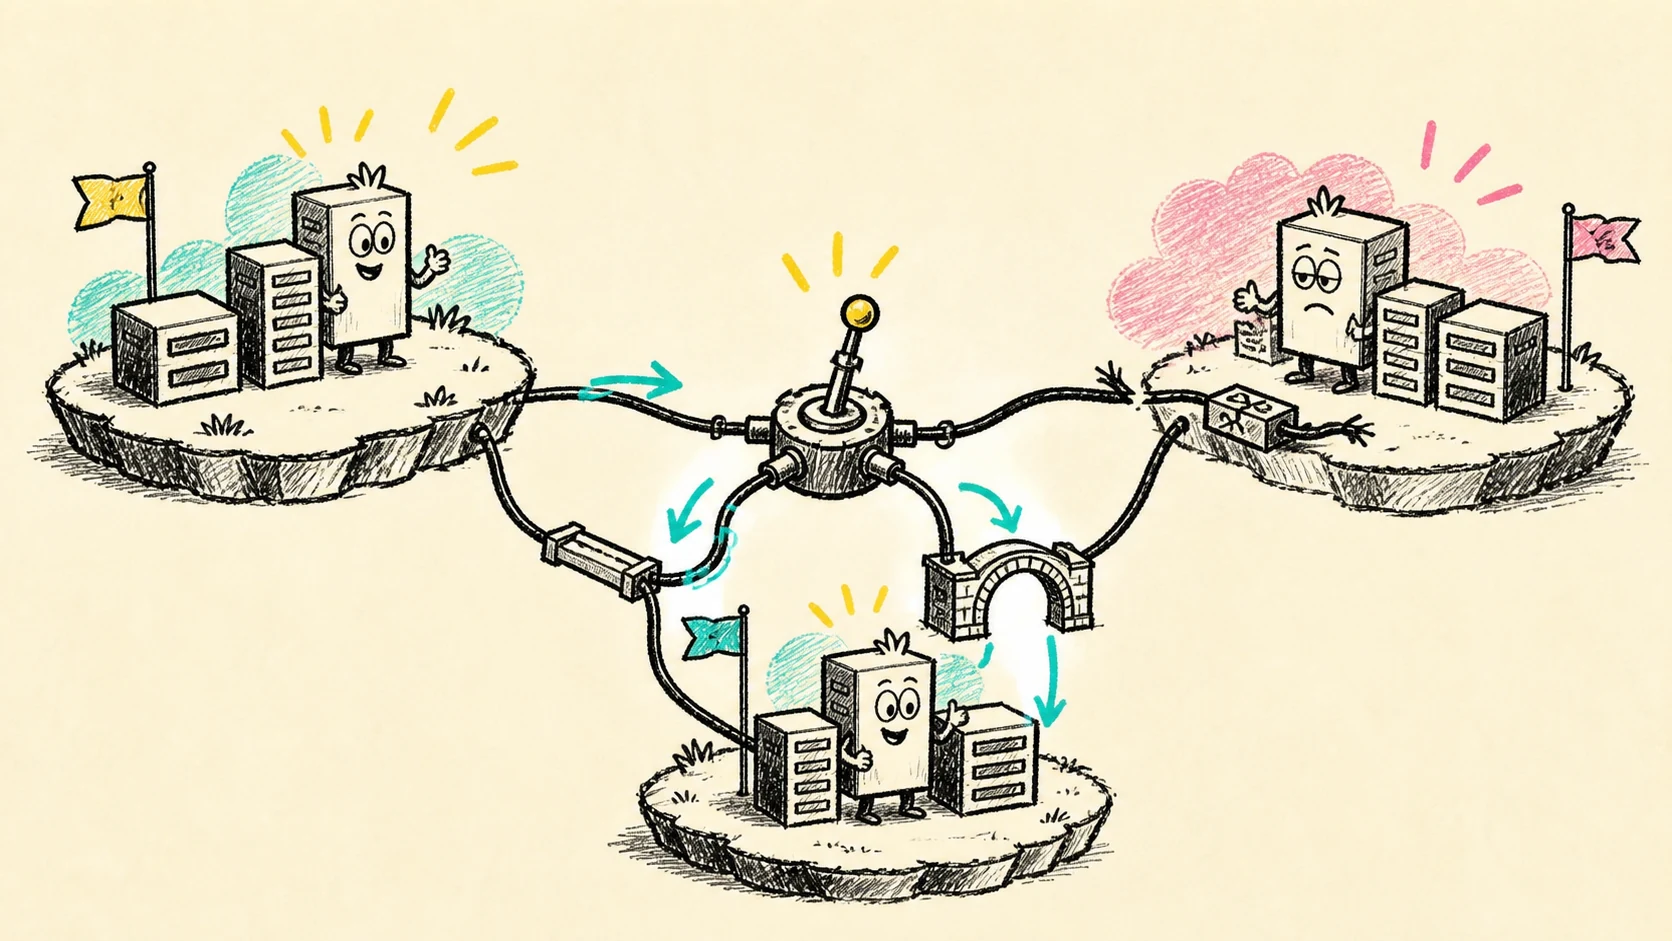
Три Kubernetes-кластера ещё не дают отказоустойчивость сами по себе. Если сервисы не умеют обнаруживать здоровые копии за пределами своего кластера, региональная авария всё равно превращается в ручное переключение DNS и долгий runbook. Linkerd Multicluster позволяет связать кластеры, но выбор режима связи должен зависеть от семантики конкретного сервиса, а не от единого платформенного шаблона.
Проблема: резерв есть, маршрута к нему нет
Multi-region часто строят как набор одинаковых кластеров. Команды считают, что наличие реплик в двух или трёх регионах автоматически означает failover. На практике клиент продолжает обращаться к локальному Kubernetes Service. Когда кластер или регион исчезает, копия приложения в соседнем регионе остаётся недоступной: DNS, endpoint discovery и доверие между кластерами не объединены.
Linkerd решает эту задачу на уровне service mesh. Его multicluster-компоненты создают в каждом кластере представление удалённых сервисов и поддерживают mTLS между прокси. Но у Linkerd не один межкластерный режим, а три. Их можно сочетать в одной топологии и выбирать метками для каждого Service.
Это важнее, чем кажется. Автоматическое переключение подходит не всем. Одному сервису нужна единая точка входа независимо от региона, другому — строгая привязка к данным в конкретной юрисдикции, третьему — доступ через gateway, потому что сети Pod между кластерами не маршрутизируются.
Три режима и разные контракты
Federated service объединяет одноимённые сервисы из нескольких кластеров в новый Service с суффиксом -federated. Его endpoints включают Pod из всех связанных кластеров. Клиент не знает, где выполняется запрос, а Linkerd распределяет трафик между доступными endpoint. Если один кластер выпадает, его Pod исчезают из набора, и балансировщик использует оставшиеся.
Flat mirroring экспортирует удалённый сервис под именем, в которое входит имя кластера. Трафик идёт непосредственно к удалённым Pod. Клиент сам выбирает регион, поэтому такой режим полезен для data locality, контролируемого fallback и сервисов, где география — часть контракта. Цена этого контроля — необходимость маршрутизировать Pod CIDR между сетями и реализовать переключение на стороне клиента или отдельного TrafficSplit.
Gateway mirroring тоже сохраняет кластер в имени сервиса, но отправляет запросы через multicluster gateway. Маршрутизация Pod-to-Pod не нужна: достаточно достижимости gateway. Это практичный вариант для изолированных сетей и singleton-сервисов, однако отказ целевого кластера или его gateway не превращается в автоматический failover.
Полезное правило выбора простое: federation — когда клиенту всё равно, где работает копия; flat mirror — когда клиент должен выбрать регион и сеть плоская; gateway mirror — когда прямой связности между Pod нет. Пытаться загнать все сервисы в один режим опасно: платформа либо теряет автоматизм, либо скрывает от приложений важную топологию.
Сначала сеть и доверие
Для flat и federated режимов адресные диапазоны Pod и Service во всех кластерах должны быть уникальными. Одного VPC peering недостаточно: маршруты Pod CIDR нужно действительно экспортировать и импортировать. Плохая конфигурация особенно неприятна тем, что DNS продолжает работать, а TCP-соединения просто зависают.
Проверять надо не наличие объекта peering, а полный путь пакета в обе стороны. В staging стоит заранее завести таблицу CIDR, тесты связности между Pod и проверку обратного маршрута. Пересечение диапазонов — архитектурная ошибка, которую поздно и дорого исправлять после заполнения кластеров workload.
Вторая основа — общая цепочка доверия. Кластеры должны доверять единому trust anchor, иначе межкластерный mTLS не сложится. При этом issuer-сертификат лучше выпускать отдельно для каждого кластера. Тогда компрометация или плановая ротация issuer не требует одновременно трогать весь mesh. Root CA и ключи issuer нельзя генерировать одноразовым demo-скриптом в production: их жизненный цикл должен быть частью PKI-процесса, с cert-manager или эквивалентным контроллером, ограниченным доступом и проверяемой ротацией.
Топология ссылок — это production-объект
Для симметричной federation каждый кластер должен получать сервисы остальных. В трёхкластёрной full mesh это шесть направленных links. Link CR сам по себе ещё не доказывает, что зеркалирование работает: для каждой потребляемой связи нужен service-mirror controller. Поэтому linkerd multicluster check следует дополнять проверкой созданных Service и их фактических endpoints.
Один Link нельзя одновременно использовать как flat и gateway-связь. Если к одному кластеру нужны оба пути, создают две ссылки с разными именами и отдельными контроллерами. Это стоит описать в GitOps-репозитории как явную матрицу: источник, потребитель, режим, ожидаемый контроллер и набор экспортируемых сервисов.
Экспорт тоже должен быть минимальным. NetworkPolicy ограничивает межкластерный трафик только нужными направлениями, а Linkerd authorization policy задаёт, какие identity могут обращаться к сервису. Общий trust anchor не означает, что любой workload любого кластера должен получить доступ ко всему.
Failover надо доказывать отказом
Зелёные health checks не подтверждают региональную устойчивость. Нужен регулярный chaos-тест: прекратить работу workload в одном кластере и наблюдать поведение всех трёх режимов.
Для federated service успешный результат — endpoints отказавшего кластера исчезают, а запросы без изменения конфигурации идут в оставшиеся регионы. Но «ноль ошибок» нельзя принимать на веру из короткого теста: измеряйте долю 5xx, latency во время convergence, время удаления endpoint и запас мощности у принимающих кластеров. Автоматическое переключение бесполезно, если соседний регион после него упирается в лимиты.
Для flat mirror и gateway mirror ошибка при отказе выбранного региона ожидаема. Тест должен подтвердить другой контракт: клиент выполняет retry или переключается на второе имя, TrafficSplit меняет маршрут либо система быстро и понятно сообщает об отсутствии допустимого fallback. Нельзя маскировать такой результат как дефект mesh — явный выбор региона означает явную ответственность за fallback.
Возврат кластера тоже часть сценария. После восстановления убедитесь, что его endpoints вернулись, доля трафика выровнялась, сертификаты действительны, а сервис не вошёл в federation с меньшим числом реплик. Иначе формально здоровый регион получит неожиданно малый или, наоборот, чрезмерный вес.
Наблюдаемость и эксплуатационные ограничения
Минимальный мониторинг должен показывать здоровье links и controllers, число endpoints у federated service, ошибки gateway, межкластерную latency и долю трафика по регионам. Сигнал о падении endpoint count полезнее общего «mesh healthy»: именно он показывает, что резервная копия исчезла из доступного пула.
Federation не заменяет глобальный ingress, управление состоянием и план восстановления данных. Она маршрутизирует service-to-service трафик между работающими копиями. Если база остаётся единственной, записи нельзя безопасно выполнять в нескольких регионах или приложение зависит от локального хранилища, единый Service этого не исправит.
Есть и цена сложности: число направленных links растёт, PKI становится общей зависимостью, плоская сеть расширяет зону маршрутизации, а ошибочная метка может изменить путь production-трафика. Поэтому начинайте с одного stateless-сервиса, фиксируйте топологию в Git, вводите policy на разрешённые экспорты и только после измеренного failover расширяйте охват.
Вывод
Хорошая multicluster-платформа не обещает одинаковое переключение для всего. Она даёт сервису подходящий контракт: автоматическую federation для взаимозаменяемых копий, flat mirror для осознанного выбора региона и gateway mirror для сетевой изоляции. Надёжность появляется не после установки Linkerd, а после проверки маршрутов, разделения issuer, ограничения доступа, мониторинга endpoints и регулярного отключения целого кластера в staging.
Источник и лицензия
Автор исходной статьи — Dominik Táskai, CNCF Ambassador и участник проекта Linkerd. Оригинал «Federating clusters for zero-downtime Kubernetes» опубликован 27 июля 2026 года в корпоративном инженерном блоге Cloud Native Computing Foundation. Материал доступен по лицензии Creative Commons Attribution 3.0 согласно условиям Linux Foundation. Это самостоятельная русская адаптация: текст переведён, сокращён и редакционно переработан; правообладатель её не одобрял и не спонсировал.