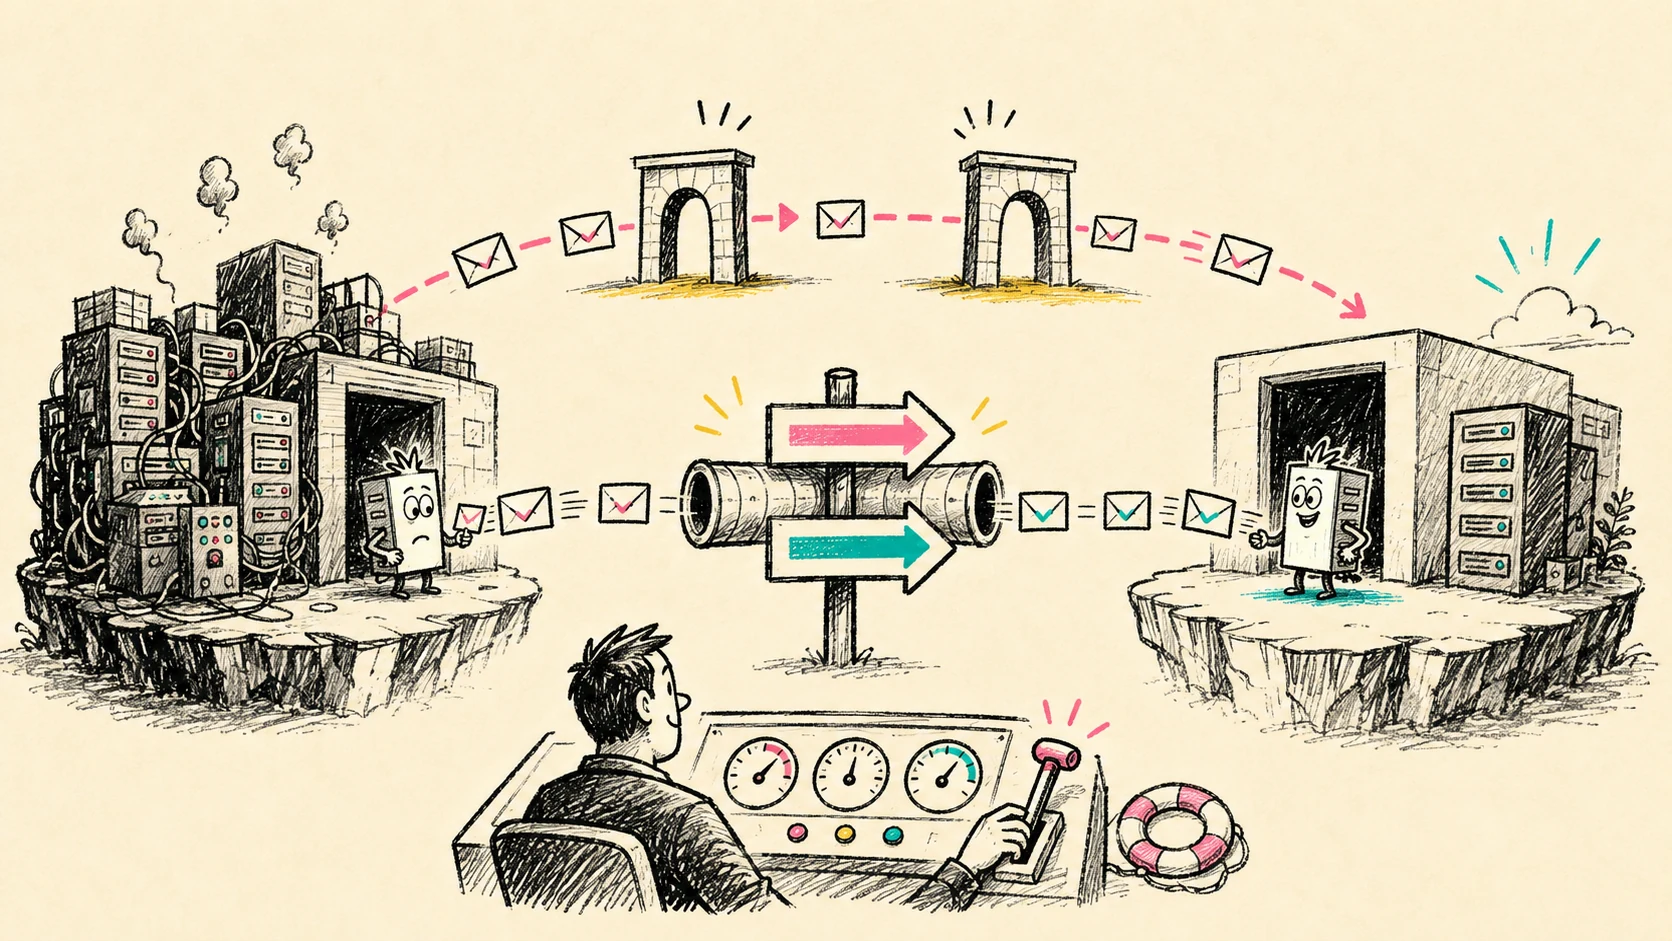
Перенести критичный Kubernetes-сервис из default в отдельный namespace трудно не из-за Deployment. Проблема — в старом DNS-имени, десятках независимых клиентов и внешнем маршруте через Ingress. Безопасная миграция разделяет эти контуры, временно сохраняет старый адрес и делает каждый шаг проверяемым и обратимым.
Почему обычный перенос создаёт окно отказа
Namespace входит в идентичность большинства Kubernetes-объектов. Deployment, Service, Secret, ConfigMap, ServiceAccount, RoleBinding и Ingress нельзя просто «переместить»: в новом namespace создаются новые объекты. Вместе с Service меняется и полное DNS-имя — например, auth-svc.default.svc.cluster.local превращается в auth-svc.authentication.svc.cluster.local.
Если все клиенты принадлежат одной команде и выкатываются одновременно, можно заменить адрес одним релизом. В реальной платформе потребителей много, их циклы поставки не синхронизированы, а часть приложений месяцами не перезапускается. Попытка согласовать атомарный cutover превращает техническую миграцию в организационную блокировку.
У сервиса обычно два независимых пути трафика. Внутренние клиенты обращаются к Kubernetes Service через cluster DNS. Внешние пользователи приходят через Ingress или Gateway. Исправить только один путь — значит оставить половину системы в аварийном состоянии.
Сначала инвентаризация, потом YAML
До создания нового namespace составьте карту зависимостей. Для внутреннего трафика ищите полные и короткие DNS-имена, переменные окружения вида *_SERVICE_HOST, hardcoded ClusterIP, записи service mesh и NetworkPolicy. Короткое имя auth-svc разрешается относительно namespace клиента и может вести не туда, куда предполагает автор миграции.
Отдельно перечислите внешние host/path, TLS-секреты, аннотации ingress-контроллера, middleware и DNS-записи. Проверьте namespace-scoped зависимости: ServiceAccount, RoleBinding, Secret, ConfigMap, PodDisruptionBudget, HPA, policy и мониторинговые ресурсы. PersistentVolume не namespace-scoped, но PersistentVolumeClaim — да; stateful workload требует отдельного плана данных.
Зафиксируйте сигналы успеха до cutover: число запросов по старому и новому адресу, долю 4xx/5xx, latency, активные соединения, readiness новых Pod и бизнес-метрику критического пути. Без исходного baseline команда увидит графики, но не поймёт, стала ли миграция причиной деградации.
Старое имя как временный DNS-алиас
Для клиентов, которые используют DNS, старый Service можно заменить объектом ExternalName, указывающим на новый Service:
apiVersion: v1
kind: Service
metadata:
  name: auth-svc
  namespace: default
spec:
  type: ExternalName
  externalName: auth-svc.authentication.svc.cluster.local
CoreDNS вернёт CNAME на новое имя. Kubernetes не создаёт для такого Service ClusterIP, endpoints или прокси-маршрут: перенаправление происходит только в DNS. Поэтому сначала надо поднять workload и обычный Service в целевом namespace, проверить readiness и доступ по новому FQDN, а уже затем менять старый объект.
У схемы есть важное ограничение. Официальная документация Kubernetes предупреждает, что ExternalName может ломать HTTP и HTTPS: клиент подключается по старому имени, но HTTP Host и TLS SNI не совпадают с целевым hostname. Для обычного внутрикластерного HTTP это может быть незаметно, если сервер не проверяет host. Для HTTPS, virtual hosting, service mesh и клиентов с проверкой сертификата тест обязателен. Если протокол зависит от имени, понадобится другой переходный механизм — например, прокси, временный Service без selector с управляемыми EndpointSlice или изменение конфигурации клиентов.
DNS-алиас не спасёт потребителей с hardcoded IP. Не сработает он и для приложений, которые получили старый ClusterIP через environment variables при запуске: после замены Service они продолжат использовать сохранённое значение до рестарта. Именно поэтому discovery надо проверять не только поиском строк в репозиториях, но и наблюдением реального трафика.
Cutover как последовательность обратимых шагов
Надёжный порядок выглядит так:
- Создать целевой namespace и все зависимости, не меняя production-трафик.
- Развернуть новую копию приложения и дождаться readiness, прогрева кэшей и подключения к downstream.
- Проверить новый Service из нескольких namespace и через тот же mesh/proxy, которым пользуются клиенты.
- Заменить старый Service на
ExternalNameлибо включить выбранный переходный прокси. - Подтвердить по метрикам и трассам, что запросы к старому адресу доходят до новых Pod.
- Масштабировать старый Deployment до нуля, но не удалять его сразу.
- Выдержать наблюдаемый период, затем убрать старые объекты и алиас по отдельному change.
Scale-to-zero сохраняет быстрый rollback: старые Pod можно вернуть, пока манифесты, секреты и зависимости ещё существуют. Но rollback тоже надо отрепетировать. Возврат старого Deployment бессмысленен, если Service уже стал ExternalName; сценарий должен включать восстановление его прежнего типа и selector.
Не держите алиас бессрочно. Назначьте владельца, deadline и метрику оставшихся обращений к старому имени. Иначе временный мост станет новым легаси, а следующий переезд снова упрётся в неизвестных потребителей.
Внешний маршрут переключается отдельно
Ingress не использует старое внутреннее DNS-имя тем же способом, поэтому ему нужен собственный overlap. Сначала создайте маршрут к Service в новом namespace, проверьте его через тестовый host или контролируемую долю трафика, затем переключите production-host и только после подтверждения удаляйте старый маршрут.
Политика, запрещающая одинаковый host в двух namespace, защищает от неоднозначной маршрутизации. Обходить её постоянной дырой нельзя. Если контролируемый overlap действительно необходим, исключение должно быть узким: конкретный namespace и host, ограниченный срок, владелец, audit trail и автоматическое истечение. Поведение двух одновременно существующих Ingress зависит от конкретного контроллера; нельзя считать, что он детерминированно выберет новый объект.
Для критичного внешнего пути безопаснее использовать возможности самого ingress-контроллера или Gateway API: weighted routing, canary, отдельный backend либо явное изменение одного маршрута. Выбор проверяют в staging на той же версии контроллера и с теми же admission policies.
Что наблюдать во время миграции
Одного kubectl get pods мало. Нужны четыре слоя проверки:
- DNS: старое имя возвращает ожидаемый CNAME, TTL известен, резолв работает из реальных клиентских namespace;
- сеть: NetworkPolicy, mesh authorization и egress позволяют путь к новому Service;
- приложение: ошибки, latency, saturation и бизнес-операции не деградируют;
- маршрутизация: трассы или access logs подтверждают, что старое имя и внешний host приходят именно в новые Pod.
После scale-to-zero продолжайте наблюдать хотя бы один полный цикл типичной нагрузки. Отдельно проверьте cron-задачи, редкие интеграции и долго живущие соединения: они часто не попадают в короткий smoke test.
Ограничения паттерна
DNS-переадресация подходит для stateless-сервиса с DNS-based discovery и совместимым протоколом. Она не переносит данные, не копирует namespace-scoped конфигурацию и не гарантирует бесшовность для TLS, hardcoded IP, старых environment variables или клиентов с агрессивным DNS-кэшированием. Stateful-сервисы, очереди и базы требуют отдельной репликации и проверки семантики записи.
Наконец, «без downtime» — не свойство YAML, а проверяемый SLO. Формулируйте допустимую долю ошибок и время переключения, собирайте доказательства в staging и оставляйте rollback до окончания наблюдаемого периода.
Вывод
Миграция между namespace становится управляемой, когда команда перестаёт считать её перемещением Deployment. Это смена адреса и границ владения. Разделите внутренний DNS и внешний ingress, сохраните старое имя только как временный совместимый мост, измерьте реальный трафик, выключите старую копию обратимым шагом и удаляйте её после выдержки. Тогда десятки клиентов смогут обновляться в своём темпе, а критичный сервис — переехать без общего релиза.
Источник и лицензия
Автор исходной статьи — George Sims; в byline CNCF указана организация Downtherabbithole.dev. Оригинал «Migrating a critical Kubernetes deployment from the default namespace without any downtime» опубликован 3 сентября 2026 года в корпоративном инженерном блоге Cloud Native Computing Foundation. Материал доступен по лицензии Creative Commons Attribution 3.0 согласно условиям Linux Foundation. Это самостоятельная русская адаптация: текст переведён, сокращён, дополнен ограничениями из актуальной документации Kubernetes и редакционно переработан; правообладатель её не одобрял и не спонсировал.