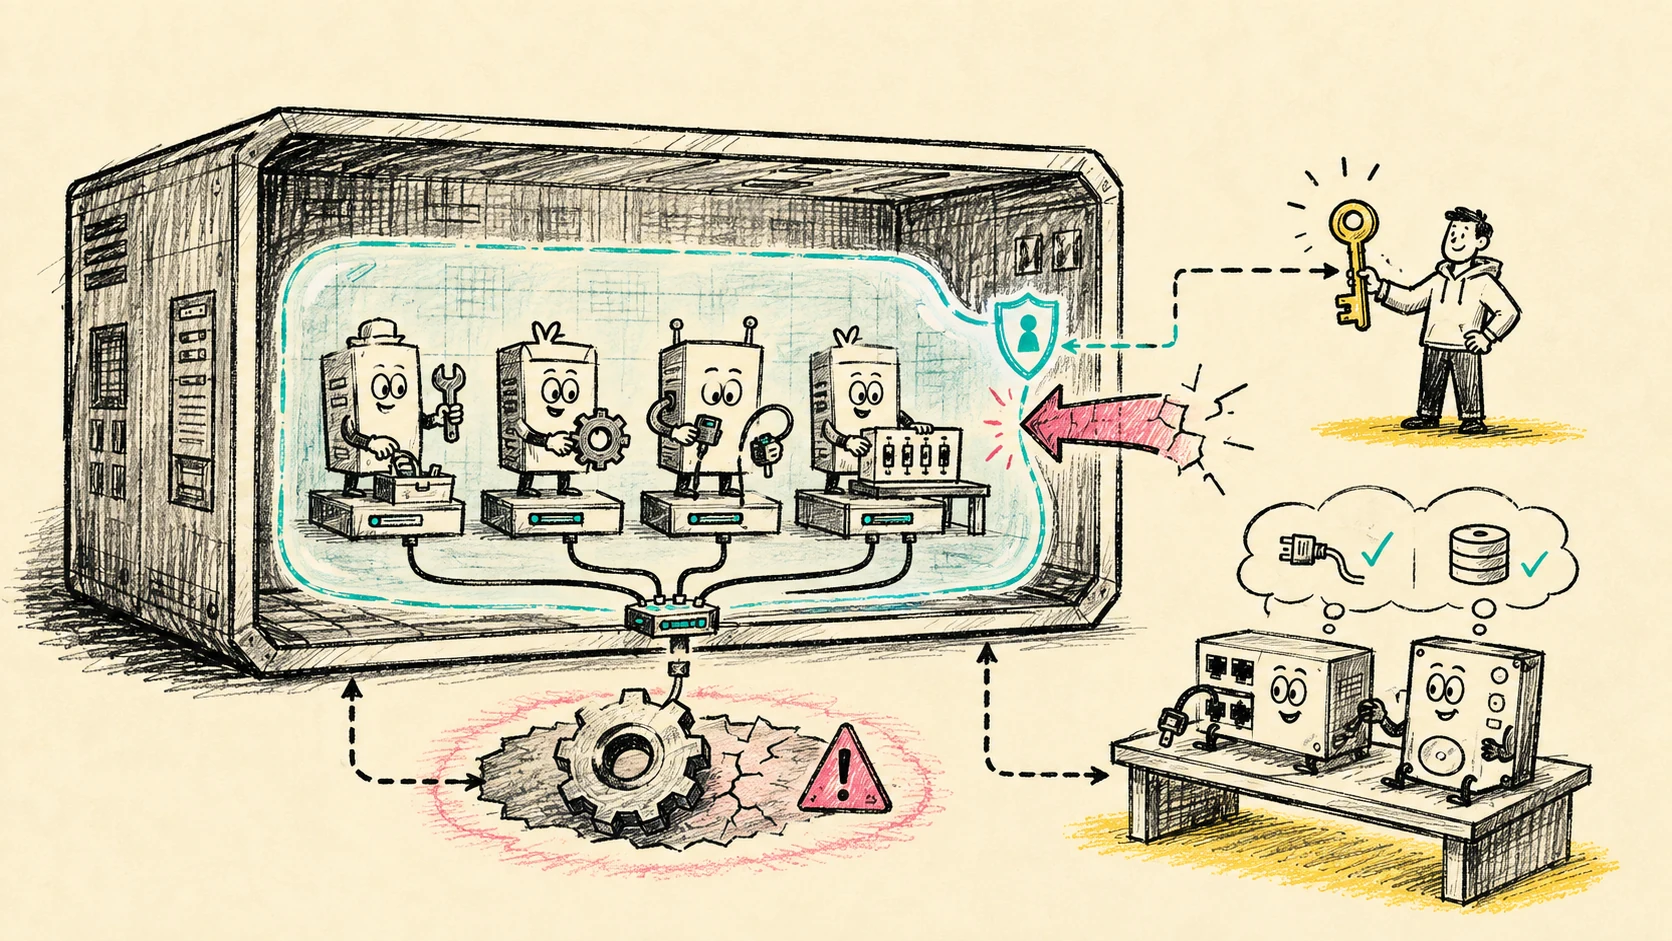
Kubernetes 1.37 переводит KubeletInUserNamespace в Beta и включает feature gate по умолчанию. Это уменьшает последствия части container-breakout уязвимостей: node-компоненты работают внутри Linux user namespace, а их «root» отображается в непривилегированного пользователя хоста. Но обновление кластера само по себе ничего не переключает, а ошибки ядра и несовместимые CNI/CSI никуда не исчезают.
Это русская адаптация и инженерный разбор статьи Akihiro Suda (NTT) «Kubernetes v1.37: KubeletInUserNamespace (aka Rootless mode) Graduates to Beta», опубликованной Kubernetes 4 сентября 2026 года. Материалы сайта доступны по CC BY 4.0. Текст переработан с упором на модель угроз, rollout и эксплуатационные ограничения.
Проблема начинается ниже Pod Security
Pod Security, seccomp, AppArmor и запрет privileged уменьшают возможности workload. Но kubelet, container runtime, CNI, kube-proxy и другие node-компоненты исторически выполняют привилегированные операции от root на хосте. Ошибка на границе контейнера способна превратить доступ к одному workload в полный контроль над машиной.
В исходной статье перечислены реальные примеры: CRI-O принимал опасный kernel.core_pattern, runc обходил masked paths через гонку с volume mount, kubelet исполнял команды через gitRepo volume, а containerd обрабатывал специально подготовленные labels образа. Детали различаются, но общий риск один: компрометация привилегированного node-компонента даёт атакующему UID 0 в начальном пространстве пользователей хоста.
Rootless-режим меняет эту границу. Компонент видит UID 0 внутри user namespace, но ядро отображает его в обычный UID, например 1000, снаружи. «Внутреннего root» хватает для многих операций с mount, cgroup и network namespace, однако его полномочия ограничены пространством имён.
Если атакующий выходит из контейнера через уязвимость runtime или kubelet, потенциальный ущерб замыкается на непривилегированной учётной записи хоста. Он не должен получить возможность незаметно менять ядро, загрузчик или firmware. Это снижение blast radius, а не доказательство безопасности узла.
Rootless node и user namespace для Pod — разные механизмы
KubeletInUserNamespace легко спутать с hostUsers: false. В первом случае user namespace окружает node-компоненты: kubelet, CRI/OCI runtime, CNI plugins и kube-proxy. Во втором — конкретный Pod получает собственное отображение UID, а node-компоненты могут продолжать работать как root на хосте.
Поддержка user namespaces для Pod стала GA в Kubernetes 1.36. Rootless node в 1.37 остаётся Beta. Механизмы не конфликтуют и могут использоваться вместе. Именно комбинация позволяет запускать вложенный Kubernetes внутри user-namespaced Pod без полного privileged: true.
Разделение важно для threat model. hostUsers: false защищает хост от процесса внутри Pod, но не убирает привилегии самого kubelet. KubeletInUserNamespace ограничивает node stack, но не превращает каждый workload в отдельный user namespace. Для защиты обеих границ нужны две настройки и совместимая инфраструктура.
Включённый feature gate не делает кластер rootless
В Kubernetes 1.37 gate KubeletInUserNamespace включён по умолчанию. Это звучит как изменение поведения после upgrade, но фактически gate лишь разрешает kubelet работать в уже созданном user namespace. Kubernetes не создаёт его автоматически и не переносит существующие узлы.
Сам feature gate делает немного: kubelet игнорирует ожидаемые permission errors при настройке некоторых sysctl, включая vm.overcommit_memory и kernel.panic, а также при чтении /dev/kmsg. User namespace должен подготовить внешний механизм. В официальном материале для локальных кластеров приведены rootless Docker, Podman или nerdctl с kind и minikube; k3s поддерживает собственный rootless mode.
После перехода Node API публикует свойство runningInUserNamespace. Администратор может использовать его как проверяемый сигнал, а затем назначать labels или taints. Это позволяет отделить rootless-пул от обычных узлов и не отправлять туда workload, которому требуется настоящий host root, например установщик несовместимого CNI.
Наличие поля полезно и для compliance. Вместо декларации «этот node pool должен быть rootless» появляется наблюдаемое состояние конкретного Node. Но Kubernetes не навешивает нужную политику автоматически: контроллер, admission-правила, инвентарь и алертинг остаются задачей платформы.
Что rootless не останавливает
User namespace ограничивает права процессов, но не исправляет уязвимости Linux kernel. Если атака использует ошибку ядра, граница namespace может не помочь. Официальная рекомендация — сочетать rootless с обычным hardening, включая seccomp, который закрывает ненужные системные вызовы.
Вторая граница — совместимость. CNI и CSI часто работают около самых привилегированных частей системы: создают интерфейсы, меняют маршруты, монтируют тома, управляют ownership и обращаются к host paths. «Fake root» внутри namespace поддерживает не все варианты этих операций. Статья прямо предупреждает, что отдельные драйверы могут сломаться.
Третья граница — окружение хоста. Развитие rootless Kubernetes опирается не только на kubelet. Linux 6.3 добавил idmapped tmpfs, Kubernetes 1.33 включил user namespaces для Pod по умолчанию, а containerd 2.1 получил writable cgroups. Версия control plane не доказывает наличие всех предпосылок на worker node.
Наконец, Beta не означает готовность любого managed Kubernetes. Провайдер должен поддержать создание user namespace, runtime, сеть, storage и жизненный цикл узла. Если сервис не документирует rootless worker nodes, одного доступного feature gate недостаточно.
Как проверить режим без риска для рабочего пула
Начните с модели угроз. Зафиксируйте, от каких атак ожидается защита: компрометация runtime, kubelet или CNI; ошибка workload; вредоносный образ; уязвимость ядра. Rootless полезен против части первого класса, но не заменяет patch management, запрет опасных Pod и изоляцию tenant.
Соберите отдельный node pool. Не переключайте существующие worker nodes на месте, пока не проверены runtime, CNI, CSI, device plugins, observability agents и операции обслуживания. Маркируйте новые узлы по фактическому runningInUserNamespace, а не по имени node group.
Прогоните сценарии, где чаще всего скрывается несовместимость:
- создание и удаление network namespace, Service и NetworkPolicy;
- монтирование block и filesystem volumes, изменение ownership, attach и detach;
- перезапуск kubelet и runtime, reboot узла и drain;
- работа DaemonSet с hostPath, eBPF, device plugin и доступом к
/procили/sys; - сбор логов, kernel events и node metrics после ограничения
/dev/kmsg; - восстановление Pod и томов после аварийного завершения node-компонента.
Условие успеха — не только Node Ready. Сравните ошибки CNI/CSI, время запуска Pod, зависшие mount и detach, сетевые потери, события kubelet и полноту телеметрии. Отдельно докажите, что процесс внутри namespace отображается в ожидаемый непривилегированный UID на хосте.
После проверки переносите stateless workload без специальных host-привилегий. Для системных DaemonSet и stateful-сервисов заведите явные исключения, а не молчаливый fallback. Если scheduler может смешивать rootless и rootful nodes, правила размещения должны отражать эту разницу.
Ограничения и эксплуатационный долг
Rootless node создаёт новую разновидность инфраструктуры. Runbook должен отвечать, как диагностировать permission error внутри вложенных namespaces, кто владеет внешней учётной записью, где лежат runtime data и как безопасно удалить узел. Резервное копирование и forensic-сбор тоже требуют проверки: привычный rootful-агент может потерять часть видимости.
Не стоит обещать, что rootless блокирует любой container escape. Он ограничивает полномочия процесса после части выходов, но атака на kernel или ошибочно доступный host resource может пересечь эту границу. Эффект зависит от конфигурации namespace и компонентов вокруг kubelet.
Вывод
KubeletInUserNamespace в Kubernetes 1.37 добавляет полезный второй рубеж: даже привилегированный node stack больше не обязан быть root в начальном user namespace хоста. Это особенно интересно для shared HPC, локальных кластеров, AI sandbox и Kubernetes-in-Kubernetes.
Но feature gate по умолчанию не выполняет миграцию. Production-путь начинается с отдельного пула, проверки фактического runningInUserNamespace, тестов CNI/CSI и явного разделения workload. Rootless уменьшает blast radius только как часть layered hardening — рядом с обновлениями ядра, seccomp, политиками Pod и минимизацией host-доступа.