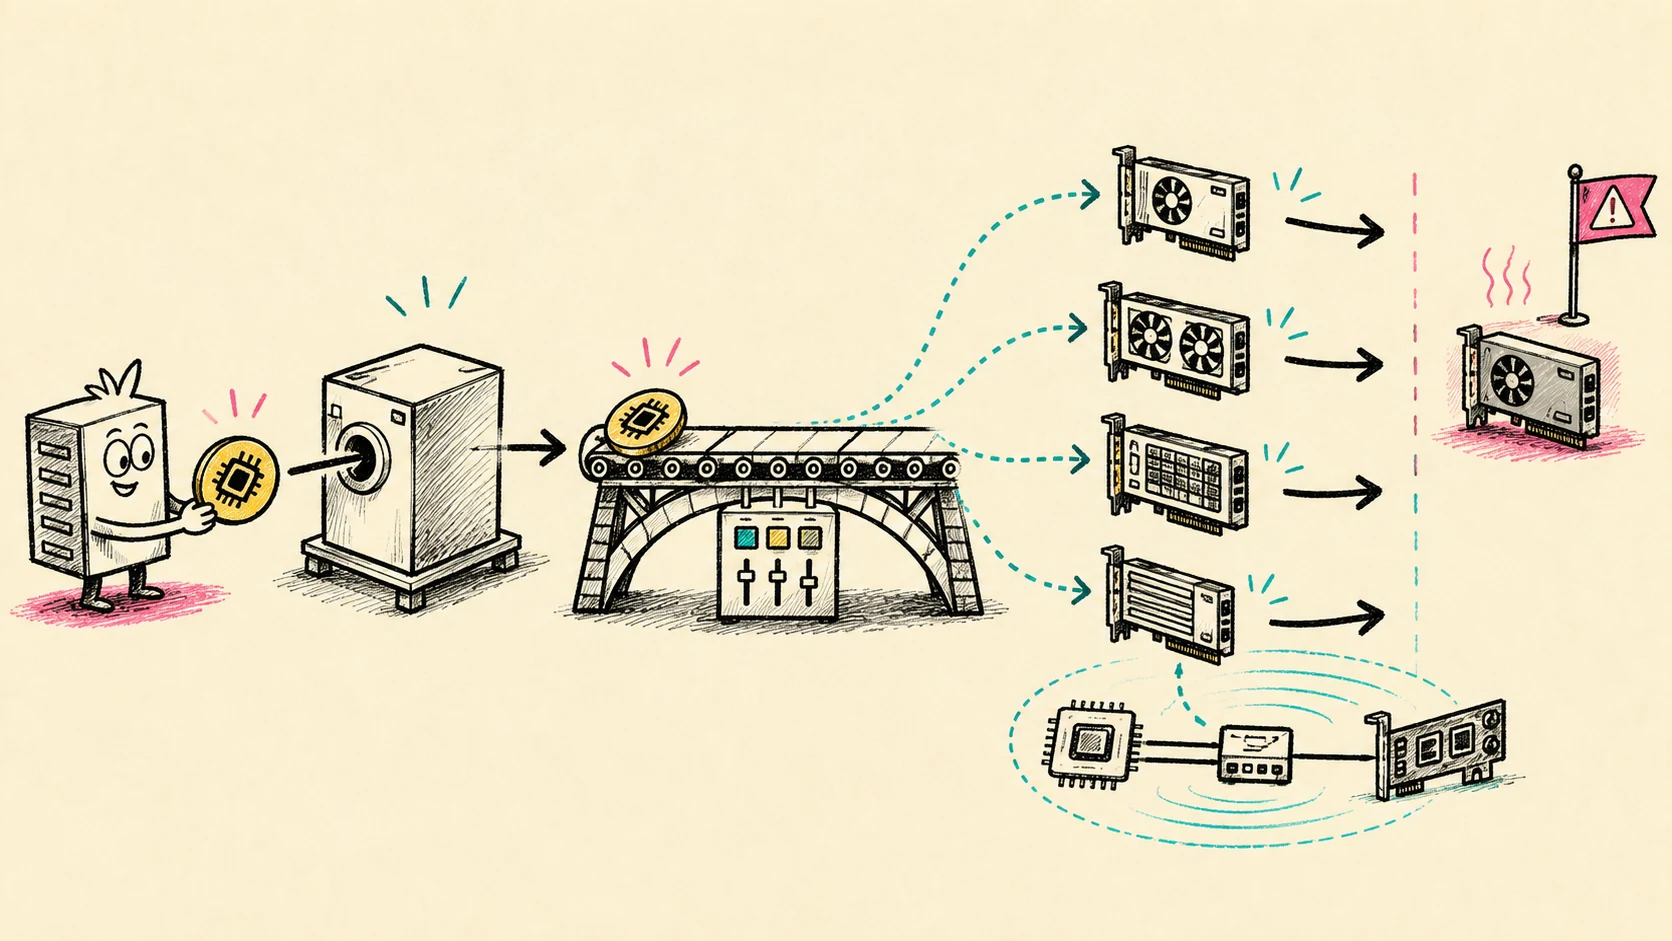
Dynamic Resource Allocation уже умеет работать с привычными extended resources без второго device plugin и без ResourceClaim в каждом workload. В Kubernetes 1.37 этот мост стал GA. Он позволяет менять механизм выдачи GPU, NIC и других устройств поэтапно, но не отменяет проверку драйвера, планировщика и сценариев отказа.
Это русская адаптация и инженерный разбор статьи Kashish Verma «Kubernetes v1.37: DRA Updates», опубликованной Kubernetes 3 сентября 2026 года. Материалы сайта доступны по CC BY 4.0. Текст переработан: вместо каталога всех новинок релиза здесь разобран переход с extended resources на DRA и эксплуатационные границы этого пути.
Почему миграция устройств обычно застревает
Приложения годами запрашивали ускоритель как целочисленный ресурс: например, vendor.example/gpu: 1 в resources.limits. Такой контракт прост и уже встроен в Helm-чарты, операторы, политики и шаблоны платформы. Но за простотой скрыта бедная модель: workload сообщает имя и количество, а не требования к памяти, топологии, профилю разделения или соседству с сетевым устройством.
DRA даёт более выразительный контур. Драйвер публикует доступные устройства через ResourceSlice, администратор определяет классы, workload создаёт или использует ResourceClaim, а планировщик связывает подходящее устройство с Pod. Через CEL можно фильтровать атрибуты, передавать vendor-specific configuration и делить устройство между контейнерами или Pod, если это поддерживает драйвер.
Полная миграция на claims затрагивает слишком много потребителей сразу. Надо поменять шаблоны workload, RBAC, admission-политики, диагностику и инструкции дежурной смены. Поэтому технически удачная модель может проиграть организационно: стоимость перехода оказывается выше немедленной пользы.
GA-мост сохраняет старый контракт workload
DRA Extended Resource support решает именно переходную задачу. Администратор связывает имя extended resource с DeviceClass через extendedResourceName. После этого Pod продолжает запрашивать знакомый ресурс в resources.limits, а подбор устройства выполняет DRA. Отдельный ResourceClaim в спецификации приложения не требуется.
В Kubernetes 1.37 эта возможность стала стабильной. По истории KEP она прошла Alpha в 1.35 и Beta в 1.36. Практический смысл GA не в новом синтаксисе для разработчика, а в возможности заменить backend allocation без массового изменения workload. Старый интерфейс остаётся, механизм под ним меняется.
Такой мост полезен для платформенной команды, которая управляет сотнями репозиториев. Сначала она разворачивает DRA-драйвер, публикует DeviceClass и проверяет выдачу на отдельном пуле узлов. Затем переводит конкретное имя extended resource на новый контур. Команды приложений получают прежний контракт, а платформа — путь к более богатой модели устройств.
Но совместимость синтаксиса не означает эквивалентность поведения. Меняются объекты управления, события планировщика, зависимости от драйвера и точки диагностики. Runbook, который ищет только capacity в Node и логи старого device plugin, после миграции станет неполным.
Устройство теперь можно вывести из эксплуатации отдельно от узла
Вторая стабильная часть релиза — taints и tolerations для устройств. Драйвер может пометить конкретное устройство, чтобы планировщик не выдавал его новым Pod. Администратор может наложить такую политику через DeviceTaintRule, не меняя конфигурацию драйвера.
Это отличается от node taint. Ради деградировавшего GPU или NIC больше не обязательно закрывать весь узел для новых workload. Исправные устройства на той же машине остаются доступными. Для плотных GPU-нод это уменьшает радиус обслуживания: из планирования исключается один ресурс, а не весь вычислительный хост.
У уже запущенного workload поведение зависит от toleration: Pod с затронутым claim может быть автоматически выселен, если claim не допускает taint. Значит, операция «пометить устройство неисправным» способна стать disruptive action. Перед автоматизацией нужны политика эвикции, бюджет перезапуска и проверка, куда переедет workload. Device taint — не просто метка здоровья.
Kubernetes 1.37 также стандартизирует атрибут resource.kubernetes.io/numaNode. Драйверы разных производителей получают общее имя для NUMA-топологии, поэтому планировщик может сопоставлять, например, ускоритель и сетевую карту рядом с одним NUMA-узлом. Это стабильное соглашение об имени, а не автоматическая гарантия низкой задержки: качество данных по-прежнему зависит от драйверов.
Что в релизе ещё нельзя принимать за готовый контракт
В статье перечислены Beta- и Alpha-возможности, но их нельзя смешивать с GA-мостом. Поддержка ResourceClaim для групп workload перешла в Beta за выключенным по умолчанию feature gate DRAWorkloadResourceClaims. Она снимает старый предел резервирования claim для 256 Pod, но требует осознанного включения и отдельной проверки контроллеров.
Данные устройства через Downward API ориентированы, в частности, на передачу PCI-адреса, MAC и других атрибутов в KubeVirt VM. Производные атрибуты на CEL помогают согласовать разные схемы названий у производителей. Compatibility groups должны отсеивать несовместимые комбинации разделов устройства ещё при планировании. Эти механизмы расширяют модель, но в 1.37 остаются не тем же уровнем стабильности, что extended-resource bridge.
Отдельно стоит относиться к заявлению о производительности PreQueueingHint. В ранних измерениях новая индексация переводит обработку событий claim с полного перебора неподходящих Pod к выборке затронутых и примерно удваивает throughput планирования. Это результат ранних benchmark, а не обещание для любого кластера: профиль нагрузки, число pending Pod и набор scheduler plugins изменят эффект.
Как провести переход без скачка доверия
Начните с инвентаризации имён extended resources и их потребителей. Зафиксируйте, какие Deployment, Job, очереди и autoscaler зависят от каждого имени. Отдельно найдите политики, которые валидируют resources.limits, и дашборды, читающие capacity и allocatable из Node.
Затем проверьте DRA-драйвер на изолированном node pool. Нужны не только успешные аллокации, но и отказные сценарии: устройство исчезло из ResourceSlice, драйвер недоступен, Pod удалён во время подготовки, нода перезагрузилась, claim не освобождается. Наблюдайте объекты DRA, scheduler events и логи kubelet вместе — одной метрики «Pod Running» мало.
Переводите по одному имени ресурса и оставляйте контрольную группу на старом backend. Сравнивайте время от создания Pod до запуска, долю Pending, ошибки подготовки устройства и время освобождения после завершения. Порог отката задайте до переключения, а не во время инцидента.
Для device taints разделите два действия: запрет новых назначений и выселение текущих потребителей. Первое подходит для автоматической реакции на деградацию. Второе должно учитывать disruption budget и запас совместимых устройств. Если свободной замены нет, taint способен превратить локальную неисправность в очередь Pending.
Ограничения, которые остаются после GA
Официальная документация DRA для Kubernetes 1.37 прямо указывает: scheduler не поддерживает preemption для DRA-ресурсов. Высокоприоритетный Pod не вытеснит работающий Pod, который занял нужное устройство; он останется Pending, пока ресурс не освободят завершением или ручным удалением потребителя. PriorityClass здесь не заменяет планирование ёмкости.
Кроме того, Kubernetes стандартизирует API и планирование, но не качество конкретного DRA-драйвера. Upgrade control plane сам по себе не переносит устройства на новый механизм. Нужны совместимый драйвер, корректные ResourceSlice и DeviceClass, политика доступа к объектам DRA и обновлённая наблюдаемость.
Вывод
Главная новость Kubernetes 1.37 для операторов устройств — не очередной объект API, а контролируемый путь миграции. Workload сохраняет запрос vendor.example/gpu, а платформа переносит выдачу на DRA и получает управление отдельными устройствами, стандартизированную NUMA-топологию и основу для более точного выбора ресурсов.
Начинать стоит с GA-моста и device taints, а Alpha- и выключенные Beta-возможности держать в отдельном экспериментальном контуре. Тогда переход расширяет модель устройств без одновременной переделки всех приложений и без иллюзии, что стабильный API автоматически делает зрелым весь стек драйверов.